فهرست مطالب
- مدل زبانی بزرگ (LLM) چیست؟
- توکن چیست و چرا در مدل زبانی بزرگ مهم است؟
- ترنسفورمر چیست و چه نقشی در LLM دارد؟
- مکانیزم توجه به زبان ساده
- مدلهای زبانی بزرگ از کجا آمدند؟
- آموزش مدل زبانی در چه مراحلی انجام میشود؟
- مدل زبانی بزرگ چطور پاسخ تولید میکند؟
- دما (Temperature) و تصادفی بودن پاسخ
- پنجره زمینه (Context Window) چیست؟
- مدل استدلالی چیست و چه فرقی با مدل زبانی معمولی دارد؟
- چرا مدل زبانی «توهم» میزند؟
- چطور توهم را کم کنیم؟
- کاربردهای مدل زبانی بزرگ در کسبوکار چیست؟
- تفاوت RAG و فاینتیون در مدل زبانی چیست؟
- مدلهای زبانی بزرگ مطرح کداماند؟
- محدودیتهای مدلهای زبانی بزرگ چیست؟
- از تجربه تیم siloow: LLM در پروژههای واقعی
- چطور مدل زبانی مناسب پروژه را انتخاب کنیم؟
- جمعبندی
- منابع
- سوالات متداول درباره مدل زبانی بزرگ
- مدل زبانی بزرگ چیست به زبان ساده؟
- تفاوت LLM و ChatGPT چیست؟
- توکن در مدل زبانی یعنی چه؟
- چرا مدل زبانی جواب غلط میدهد؟
- آیا میتوان مدل زبانی را روی کامپیوتر شخصی اجرا کرد؟
- پنجره زمینه بزرگتر همیشه بهتر است؟
مدل زبانی بزرگ چیست؟ مدل زبانی بزرگ یا LLM (Large Language Model) یک شبکه عصبی بسیار بزرگ است که روی حجم عظیمی از متن آموزش دیده تا تکه بعدی متن را پیشبینی کند؛ ChatGPT، Claude و Gemini همگی روی چنین مدلهایی ساخته شدهاند. همین کار بهظاهر ساده، یعنی حدس زدن «توکن بعدی»، وقتی در مقیاس میلیاردها پارامتر و تریلیونها توکن انجام شود، توانایی نوشتن، خلاصهسازی، ترجمه، کدنویسی و استدلال را به وجود میآورد.
در این راهنما میبینید LLM دقیقاً چه چیزی است، توکن و ترنسفورمر چه نقشی دارند، آموزش مدل زبانی در چه مراحلی انجام میشود، چرا مدل گاهی «توهم» میزند و پنجره زمینه، دما و مدلهای استدلالی یعنی چه. در پایان هم معیارهای انتخاب مدل برای پروژههای واقعی را مرور میکنیم.
نویسنده: تیم siloow (سیلو سولوشن) — آخرین بهروزرسانی: آبان ۱۴۰۵
مدل زبانی بزرگ (LLM) چیست؟
مدل زبانی بزرگ یک مدل یادگیری عمیق است که احتمال ادامه یک متن را محاسبه میکند و با انتخاب پشتسرهم محتملترین تکهها، متن تولید میکند. «بزرگ» به دو چیز اشاره دارد: تعداد پارامترهای مدل (معمولاً از چند میلیارد تا صدها میلیارد و بیشتر) و حجم داده آموزشی.
LLM زیرمجموعه هوش مصنوعی مولد است؛ اگر با مفاهیم پایه مثل یادگیری ماشین و یادگیری عمیق آشنا نیستید، اول مقاله هوش مصنوعی چیست را بخوانید. مدل زبانی بهخودیخود یک «فایل» از اعداد است؛ محصولاتی مثل ChatGPT یک رابط کاربری، ابزارها (جستوجو، اجرای کد، حافظه) و لایههای ایمنی را روی این مدل سوار میکنند.
| مفهوم | یعنی چه؟ | مثال |
|---|---|---|
| مدل پایه (Base model) | مدلی که فقط پیشآموزش دیده و متن را ادامه میدهد | ادامه دادن یک پاراگراف ناتمام |
| مدل دستورپذیر (Instruct/Chat) | مدل پایهای که برای پیروی از دستور و گفتوگو تنظیم شده | مدلهایی که پشت چتباتها هستند |
| مدل استدلالی (Reasoning) | مدلی که پیش از پاسخ نهایی، مراحل فکر را تولید میکند | حالتهای «Thinking» در محصولات جدید |
| مدل چندوجهی (Multimodal) | مدلی که علاوه بر متن، تصویر یا صدا را هم میفهمد | توضیح دادن یک نمودار یا عکس |
| مدل اوپنویت | مدلی که وزنهایش منتشر شده و قابل اجرا روی سرور شخصی است | Gemma، Qwen، DeepSeek، Mistral |
توکن چیست و چرا در مدل زبانی بزرگ مهم است؟
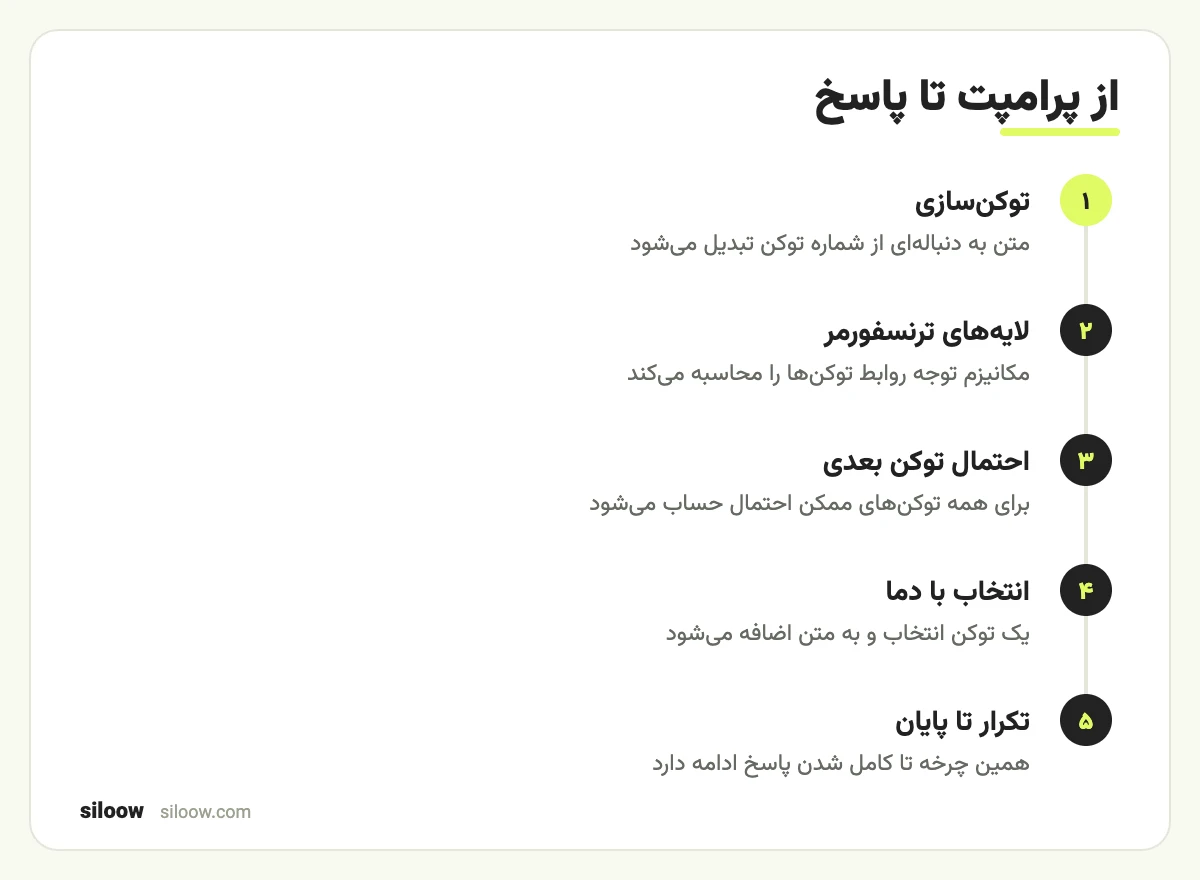
توکن کوچکترین واحد متنی است که مدل زبانی میخواند و تولید میکند؛ میتواند یک کلمه کامل، بخشی از کلمه، یک علامت نگارشی یا حتی یک فاصله باشد. مدل متن را مستقیم نمیبیند؛ ابتدا یک «توکنایزر» متن را به دنبالهای از شمارهها تبدیل میکند و مدل با همین شمارهها کار میکند.
توکن از سه جهت برای کاربر اهمیت عملی دارد:
- هزینه: قیمت APIها تقریباً همیشه بر اساس تعداد توکن ورودی و خروجی (معمولاً به ازای هر یک میلیون توکن) محاسبه میشود و توکن خروجی گرانتر از ورودی است.
- محدودیت طول: پنجره زمینه و سقف خروجی هر مدل بر حسب توکن تعریف میشود، نه کلمه.
- زبان فارسی: توکنایزرها معمولاً روی دادهای با سهم زیاد انگلیسی ساخته شدهاند؛ برای همین یک متن فارسی معمولاً به توکنهای بیشتری نسبت به معادل انگلیسیاش شکسته میشود و هم گرانتر تمام میشود و هم جای بیشتری از پنجره زمینه را میگیرد. میزان این تفاوت به توکنایزر هر مدل بستگی دارد و بهتر است روی متنهای خودتان اندازه بگیرید.
ترنسفورمر چیست و چه نقشی در LLM دارد؟
ترنسفورمر (Transformer) معماری شبکه عصبیای است که تقریباً همه مدلهای زبانی بزرگ امروز بر پایه آن ساخته شدهاند. این معماری در سال ۲۰۱۷ در مقاله Attention Is All You Need از پژوهشگران گوگل معرفی شد و نوآوری اصلیاش سازوکاری به نام «توجه» (Attention) است.
پیش از ترنسفورمر، مدلهای رایج متن (مثل شبکههای بازگشتی RNN) متن را کلمهبهکلمه و پشتسرهم پردازش میکردند؛ این کار کند بود و ارتباط کلمههای دور از هم را خوب نگه نمیداشت. به تعبیر آموزش رسمی گوگل درباره مدلهای زبانی بزرگ، RNNها اطلاعات را «توکن به توکن» ارزیابی میکنند، در حالی که LLMها میتوانند کل زمینه را یکجا ببینند.
مکانیزم توجه به زبان ساده
جمله «علی کتاب را به مریم داد چون او آن را خوانده بود» را در نظر بگیرید. برای فهم اینکه «او» به چه کسی برمیگردد، باید به کلمههای دیگر جمله نگاه کرد. مکانیزم توجه دقیقاً همین کار را انجام میدهد: برای هر توکن، محاسبه میکند که به کدام توکنهای دیگر و به چه اندازه باید «توجه» کند. ترنسفورمرها دهها لایه از این محاسبه را روی هم میچینند و هر لایه الگوهای پیچیدهتری را درمییابد؛ از دستور زبان در لایههای اولیه تا معنا و روابط مفهومی در لایههای بالاتر.
مزیت مهم دیگر ترنسفورمر این است که محاسبات آن بهخوبی روی پردازندههای گرافیکی (GPU) موازی میشود. همین موازیسازی آموزش مدلها روی دادههای عظیم را عملی کرد و راه را برای مقیاس فعلی باز کرد.
نکته: بسیاری از مدلهای بزرگ جدید از معماری «ترکیب متخصصان» (Mixture of Experts یا MoE) استفاده میکنند؛ یعنی مدل پارامترهای کل زیادی دارد ولی برای هر توکن فقط بخشی از آنها فعال میشود. برای همین در معرفی مدلها دو عدد میبینید: پارامترهای کل و پارامترهای فعال. هزینه اجرا بیشتر به عدد دوم بستگی دارد.
مدلهای زبانی بزرگ از کجا آمدند؟
مدلهای زبانی بزرگ حاصل حدود یک دهه پیشرفت پیوسته در پردازش زبان طبیعی هستند و نقطه عطف اصلی آنها معرفی معماری ترنسفورمر در سال ۲۰۱۷ بود. پیش از آن، مدلهای زبانی کوچکتر و تخصصی بودند و برای هر کار (ترجمه، خلاصهسازی، تحلیل احساس) مدل جداگانهای آموزش داده میشد.
- پیش از ۲۰۱۷: مدلهای آماری n-gram و سپس شبکههای بازگشتی (RNN و LSTM) که زمینه محدودی را به خاطر میسپردند.
- ۲۰۱۷: معرفی ترنسفورمر و مکانیزم توجه.
- ۲۰۱۸ تا ۲۰۲۰: رواج ایده «پیشآموزش روی متن عمومی، سپس تنظیم برای کار خاص» و کشف اینکه بزرگتر کردن مدل و داده، تواناییها را بهطور پیوسته بهتر میکند.
- ۲۰۲۲: مدلهای دستورپذیر و گفتوگومحور با بازخورد انسانی تنظیم شدند و ChatGPT این فناوری را عمومی کرد.
- ۲۰۲۴ تا ۲۰۲۶: مدلهای چندوجهی، مدلهای استدلالی، پنجره زمینه یکمیلیون توکنی و ایجنتهایی که با ابزارها کار میکنند.
آموزش مدل زبانی در چه مراحلی انجام میشود؟
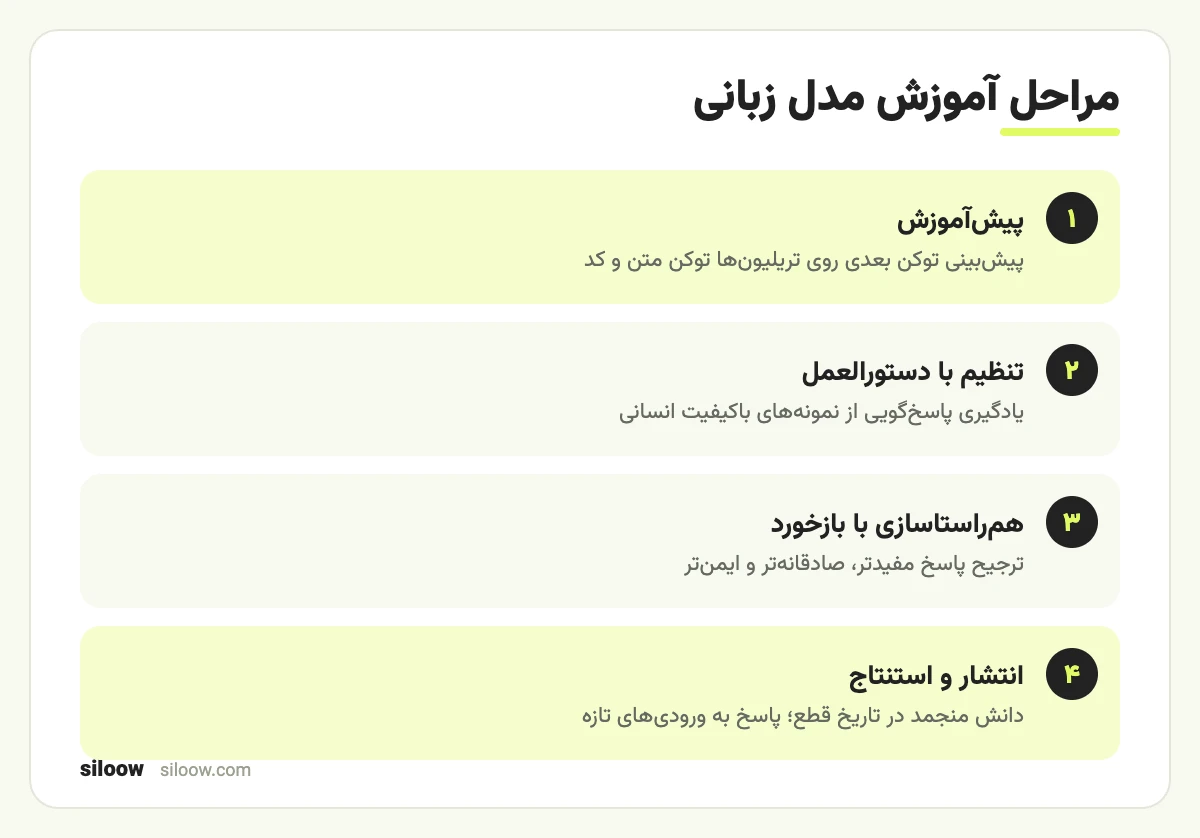
آموزش مدل زبانی بزرگ معمولاً در سه مرحله انجام میشود: پیشآموزش روی حجم عظیم متن، تنظیم با دستورالعملها و مثالهای انسانی، و همراستاسازی با بازخورد. هر مرحله هدف متفاوتی دارد و رفتار نهایی مدل حاصل ترکیب هر سه است.
- پیشآموزش (Pre-training): مدل روی تریلیونها توکن از متنهای عمومی وب، کتابها، کد و منابع دیگر آموزش میبیند و فقط یک کار یاد میگیرد: پیشبینی توکن بعدی. این مرحله گرانترین بخش است و به هزاران GPU برای هفتهها یا ماهها نیاز دارد. حاصل آن یک «مدل پایه» است که دانش زبانی و اطلاعات عمومی زیادی دارد اما هنوز دستیار خوبی نیست.
- تنظیم دقیق با دستورالعمل (Supervised Fine-Tuning): مدل روی نمونههای باکیفیت «سؤال و پاسخ» یا «دستور و انجام» که انسانها نوشته یا تأیید کردهاند تنظیم میشود تا یاد بگیرد مثل یک دستیار پاسخ دهد.
- یادگیری تقویتی و همراستاسازی (RLHF و روشهای مشابه): چند پاسخ مدل مقایسه و رتبهبندی میشود و مدل یاد میگیرد پاسخهای مفیدتر، صادقانهتر و ایمنتر بدهد. مدلهای استدلالی جدید در این مرحله با پاداش برای حل درست مسائل قابلبررسی (مثل ریاضی و کد) هم آموزش میبینند.
بعد از این مراحل، مدل منتشر میشود و وارد مرحله استنتاج میشود. نکته مهم این است که دانش مدل در لحظه پایان دادههای آموزشی منجمد میشود؛ به همین دلیل هر مدل «تاریخ قطع دانش» (Knowledge cutoff) دارد و برای اطلاعات تازهتر باید از جستوجو یا دادهای که شما در اختیارش میگذارید کمک بگیرد.
مدل زبانی بزرگ چطور پاسخ تولید میکند؟
مدل زبانی بزرگ پاسخ را توکن به توکن تولید میکند: در هر قدم، برای همه توکنهای ممکن احتمال حساب میکند، یکی را انتخاب میکند، آن را به انتهای متن اضافه میکند و دوباره همین کار را تکرار میکند تا به پایان پاسخ برسد. به همین دلیل است که در چتباتها پاسخ کلمهبهکلمه روی صفحه ظاهر میشود.
دما (Temperature) و تصادفی بودن پاسخ
انتخاب توکن بعدی همیشه «محتملترین» گزینه نیست. پارامتری به نام دما (Temperature) تعیین میکند انتخاب چقدر تصادفی باشد. دمای پایین پاسخهای قابلپیشبینیتر و یکنواختتر میدهد (مناسب استخراج داده، طبقهبندی و کد) و دمای بالاتر پاسخهای متنوعتر و خلاقانهتر (مناسب ایدهپردازی). به همین دلیل است که اگر یک سؤال را دو بار بپرسید، ممکن است دو پاسخ متفاوت بگیرید.
پنجره زمینه (Context Window) چیست؟
پنجره زمینه حداکثر تعداد توکنی است که مدل در یک درخواست همزمان میبیند؛ شامل دستورالعمل سیستم، تاریخچه گفتوگو، اسناد پیوستشده و پاسخ در حال تولید. هر چیزی بیرون از این پنجره برای مدل وجود ندارد. پنجره زمینه در مدلهای پیشرو اکنون به حدود یک میلیون توکن رسیده است؛ برای نمونه، مستندات رسمی Gemini ۴ Argon پنجره ورودی را ۱٬۰۴۸٬۵۷۶ توکن اعلام میکند.
پنجره بزرگ به این معنا نیست که مدل همه بخشهای یک متن طولانی را با دقت یکسان به کار میگیرد. در عمل، برای پرسش از اسناد زیاد، ترکیب پنجره بزرگ با بازیابی هدفمند اطلاعات (RAG) معمولاً هم ارزانتر است و هم دقیقتر.
مدل استدلالی چیست و چه فرقی با مدل زبانی معمولی دارد؟
مدل استدلالی (Reasoning Model) یک مدل زبانی بزرگ است که پیش از نوشتن پاسخ نهایی، زنجیرهای از مراحل فکر را تولید میکند؛ یعنی مسئله را میشکند، راهحلها را امتحان میکند و خطاهایش را اصلاح میکند. این مدلها در ریاضی، برنامهنویسی، تحلیل چندمرحلهای و برنامهریزی معمولاً دقیقترند، اما کندتر و گرانتر هستند، چون توکنهای «فکر» هم تولید و محاسبه میشوند.
تفاوت عملی این است که در مدل معمولی، کیفیت استدلال تا حد زیادی به پرامپت شما بستگی دارد (مثلاً اینکه بخواهید «قدمبهقدم فکر کن»)، اما در مدل استدلالی این رفتار در خود آموزش مدل نهادینه شده است. بسیاری از محصولات امروز یک «مسیریاب» دارند که بسته به سختی سؤال، بین حالت سریع و حالت استدلالی انتخاب میکند یا این انتخاب را به کاربر میسپارد.
- برای این کارها از حالت استدلالی استفاده کنید: حل مسئله چندمرحلهای، دیباگ کد پیچیده، تحلیل قرارداد یا داده، برنامهریزی پروژه.
- برای این کارها حالت سریع کافی است: بازنویسی متن، ترجمه، خلاصه کوتاه، پاسخ به سؤال ساده، دستهبندی حجم زیاد داده.
مدل استدلالی هم از توهم مصون نیست؛ ممکن است با زنجیرهای منطقینما به نتیجه غلط برسد. پس همان قواعد راستیآزمایی برای این مدلها هم برقرار است.
چرا مدل زبانی «توهم» میزند؟
توهم (Hallucination) یعنی مدل زبانی اطلاعاتی نادرست اما روان و باورپذیر تولید کند؛ مثلاً منبعی که وجود ندارد، عددی ساختگی یا نقلقولی که هیچکس نگفته است. دلیل اصلی این است که مدل برای «تولید متن محتمل» آموزش دیده، نه برای «بیان فقط حقایق تأییدشده».
پژوهشگران OpenAI در مقاله Why Language Models Hallucinate توضیح میدهند که بخشی از مشکل به نحوه ارزیابی برمیگردد: وقتی معیارهای سنجش فقط پاسخ درست را امتیاز میدهند و «نمیدانم» صفر میگیرد، مدل یاد میگیرد حدس بزند. چند عامل دیگر هم احتمال توهم را بالا میبرد:
- سؤال درباره اطلاعات کمیاب که در داده آموزشی کم تکرار شده (مثل جزئیات یک شرکت کوچک یا یک شخص کمتر شناختهشده).
- سؤال درباره رویدادهای بعد از تاریخ قطع دانش مدل.
- درخواست عدد، تاریخ، نقلقول دقیق یا لینک منبع بدون دسترسی به جستوجو.
- پرامپتهایی که پیشفرض نادرست دارند (مثلاً «چرا فلان قانون در سال X تصویب شد؟» وقتی چنین قانونی نیست).
چطور توهم را کم کنیم؟
| روش | چه کاری انجام میدهد؟ | کجا مفید است؟ |
|---|---|---|
| دادن منبع به مدل (RAG) | اسناد معتبر را کنار سؤال میگذارد تا پاسخ از روی آنها ساخته شود | چتبات پشتیبانی، پرسش از مستندات داخلی |
| فعال کردن جستوجو | مدل اطلاعات تازه را از وب میآورد و منبع میدهد | اخبار، قیمتها، نسخههای جدید نرمافزار |
| اجازه «نمیدانم» | در پرامپت صریحاً بگویید اگر مطمئن نیستی بگو | هر کاربرد حساس به دقت |
| درخواست استناد | از مدل بخواهید برای هر ادعا بخش مربوط از سند را نقل کند | خلاصه قرارداد، گزارش تحقیقی |
| بازبینی انسانی | خروجی پیش از انتشار یا اجرا توسط متخصص چک میشود | محتوای منتشرشده، کد، تصمیمهای مالی |
بسیاری از این روشها در واقع تکنیکهای پرامپتنویسی هستند که در مقاله پرامپت نویسی و مهندسی پرامپت با مثال فارسی توضیح دادهایم.
کاربردهای مدل زبانی بزرگ در کسبوکار چیست؟
کاربردهای مدل زبانی بزرگ در کسبوکار هر جایی است که متن، گفتوگو یا کد نقش اصلی دارد: پاسخگویی به مشتری، تولید و ویرایش محتوا، تحلیل بازخوردها، جستوجو در اسناد داخلی و کمک به برنامهنویسی. ارزش واقعی وقتی ایجاد میشود که مدل به داده و ابزارهای خود کسبوکار وصل شود، نه اینکه فقط یک پنجره چت عمومی باشد.
- پشتیبانی مشتری: چتباتی که از روی سؤالات متداول، شرایط ارسال و راهنمای محصولات پاسخ میدهد و موارد پیچیده را به اپراتور انسانی میسپارد.
- تحلیل نظرات: دستهبندی صدها نظر مشتری بر اساس موضوع و احساس (رضایت، شکایت، پیشنهاد) و استخراج مشکلات پرتکرار.
- استخراج داده: تبدیل فاکتورها، رزومهها یا ایمیلها به جدول و فیلدهای ساختاریافته.
- محتوا و سئو: پیشنویس توضیحات محصول، بازنویسی متنهای قدیمی و پیشنهاد ساختار مقاله؛ همیشه با ویرایش انسانی و بررسی صحت.
- جستوجوی سازمانی: پرسیدن سؤال به زبان طبیعی از آییننامهها، قراردادها و مستندات فنی.
- توسعه نرمافزار: تکمیل کد، نوشتن تست، توضیح کد قدیمی و کمک به رفع باگ.
تفاوت RAG و فاینتیون در مدل زبانی چیست؟
RAG و فاینتیون دو راه متفاوت برای «اختصاصی کردن» یک مدل زبانی بزرگ هستند: RAG دانش جدید را در لحظه پاسخ به مدل میدهد، در حالی که فاینتیون رفتار و سبک مدل را با آموزش تکمیلی تغییر میدهد. در بیشتر پروژههای تجاری، شروع با RAG ارزانتر و قابلکنترلتر است.
در RAG (تولید افزوده با بازیابی)، اسناد شما به تکههای کوچک تقسیم و نمایه میشوند؛ هنگام هر سؤال، مرتبطترین تکهها پیدا میشوند و کنار سؤال در پنجره زمینه قرار میگیرند. مزیت اصلی RAG این است که با تغییر اسناد، پاسخها فوراً بهروز میشوند و میتوان برای هر پاسخ منبع نشان داد. فاینتیون برای وقتی مناسب است که میخواهید مدل یک قالب خروجی خاص، لحن ثابت یا یک کار تخصصی تکراری را با دقت بالاتر و پرامپت کوتاهتر انجام دهد؛ اما برای «یاد دادن اطلاعات تازه» معمولاً روش مناسبی نیست، چون بهروزرسانی آن پرهزینه است و مدل همچنان ممکن است اطلاعات را اشتباه به خاطر بیاورد.
| معیار | RAG | فاینتیون |
|---|---|---|
| هدف اصلی | دادن دانش بهروز و اختصاصی | تغییر رفتار، لحن یا قالب خروجی |
| بهروزرسانی | با تغییر اسناد، فوری | نیاز به آموزش دوباره |
| امکان نمایش منبع | دارد | ندارد |
| هزینه شروع | پایین تا متوسط | متوسط تا بالا (داده برچسبخورده و آموزش) |
| مناسب برای | چتبات پشتیبانی، پرسش از مستندات | دستهبندی تخصصی، خروجی با قالب ثابت |
مدلهای زبانی بزرگ مطرح کداماند؟
مدلهای زبانی بزرگ مطرح را میتوان به دو گروه تقسیم کرد: مدلهای بسته که فقط از طریق سرویس یا API سازنده در دسترساند و مدلهای اوپنویت که وزنهایشان منتشر شده و میتوان آنها را روی زیرساخت خود اجرا کرد. انتخاب بین این دو بیشتر به نیاز به کنترل داده، هزینه و کیفیت مورد نیاز بستگی دارد.
| خانواده | سازنده | نوع دسترسی | نکته |
|---|---|---|---|
| GPT | OpenAI | بسته (ChatGPT و API) | خانواده GPT-۶ از اکتبر ۲۰۲۶ در ChatGPT عرضه شده است |
| Claude | Anthropic | بسته (Claude و API و ابرهای بزرگ) | Claude Opus ۵.۵ در ۲۲ سپتامبر ۲۰۲۶ معرفی شد |
| Gemini | بسته (اپ Gemini و API) | Gemini ۴ Argon با پنجره زمینه حدود یک میلیون توکن | |
| Gemma | اوپنویت، مجوز Apache ۲.۰ | Gemma ۴ از آوریل ۲۰۲۶؛ نسخههای کوچک قابل اجرا روی دستگاه | |
| Qwen، DeepSeek، Mistral | Alibaba، DeepSeek، Mistral AI | اغلب اوپنویت | گزینههای رایج برای اجرای محلی و خودمیزبانی |
نام نسخهها هر چند ماه یک بار عوض میشود. برای انتخاب، بهجای نام نسخه، این ویژگیها را مقایسه کنید: کیفیت در کار مشخص شما (بهخصوص به فارسی)، پنجره زمینه، قیمت هر میلیون توکن، سرعت، امکان پردازش تصویر و فایل، سیاست نگهداری داده و دسترسپذیری در منطقه شما.
محدودیتهای مدلهای زبانی بزرگ چیست؟
محدودیت اصلی مدلهای زبانی بزرگ این است که «درستی» را تضمین نمیکنند و دانششان تاریخ مصرف دارد؛ علاوه بر این، محاسبه دقیق، حافظه بلندمدت و پیروی صددرصدی از قوانین در آنها ذاتی نیست و باید با ابزار و طراحی سیستم جبران شود.
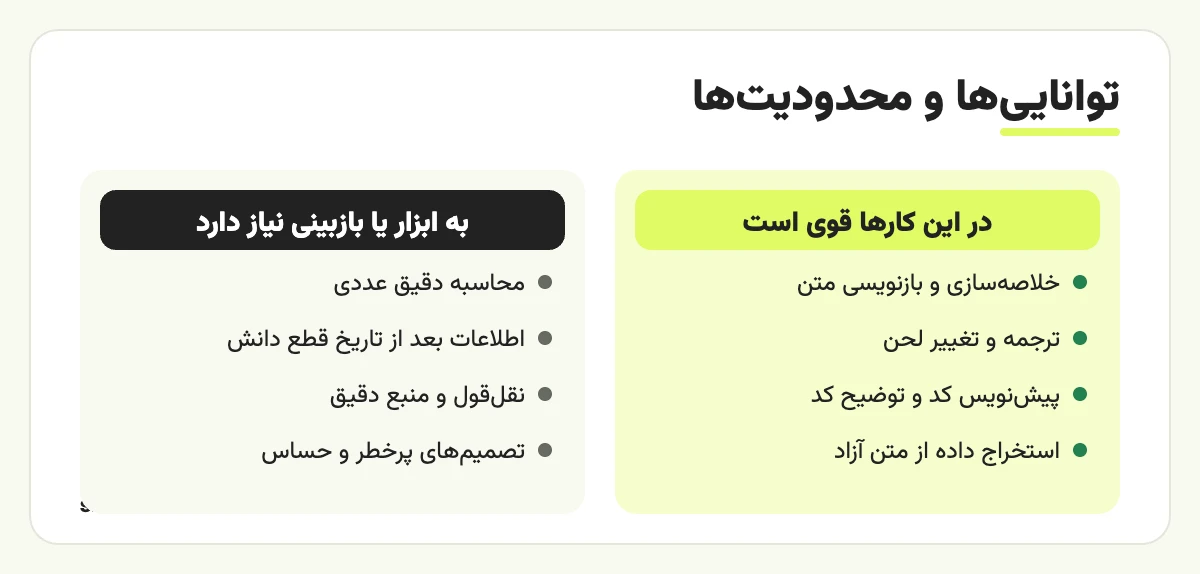
- محاسبه دقیق: مدل ذاتاً ماشینحساب نیست؛ برای حساب دقیق، بهتر است مدل به ابزار اجرای کد وصل باشد.
- حافظه: مدل خارج از پنجره زمینه چیزی به خاطر نمیآورد؛ «حافظه» محصولات چت با ذخیره خلاصهها و تزریق آنها به پنجره زمینه ساخته میشود.
- امنیت: اگر مدل متنی از منبع غیرقابلاعتماد بخواند (مثلاً یک صفحه وب)، ممکن است دستورات پنهان در آن متن را اجرا کند؛ این حمله که OWASP آن را Prompt Injection مینامد، اولین ریسک در فهرست ریسکهای امنیتی برنامههای LLM است.
- سوگیری و یکسان نبودن کیفیت زبانها: کیفیت پاسخ در زبانهای کممنبعتر از انگلیسی ممکن است پایینتر باشد.
- هزینه و تأخیر: مدلهای بزرگتر کندتر و گرانترند؛ برای بسیاری از کارها مدل کوچکتر کافی است.
از تجربه تیم siloow: LLM در پروژههای واقعی
در پروژههای وب و اپلیکیشن، تیم siloow از مدلهای زبانی بیشتر برای کارهای مشخص و قابلسنجش استفاده میکند: تبدیل متن آزاد به داده ساختاریافته (مثلاً استخراج مشخصات محصول از توضیحات)، پیشنویس محتوا برای بازبینی ویراستار، و دستیار برنامهنویسی در توسعه قالبهای وردپرس و پنلهای مدیریتی. تجربه ما این است که مشکل اصلی تقریباً هیچوقت «هوش» مدل نیست، بلکه ورودی مبهم، نبود معیار ارزیابی و اعتماد بیجا به خروجی است. هر جا خروجی مدل مستقیم وارد دیتابیس یا صفحه عمومی سایت میشود، یک لایه اعتبارسنجی (چک کردن قالب خروجی، محدوده عددها و تأیید انسانی) اضافه میکنیم؛ این لایه ساده، بیشتر خطاها را پیش از رسیدن به کاربر میگیرد. همچنین هزینه توکن متن فارسی را از ابتدا در برآورد هزینه پروژه لحاظ میکنیم.
چطور مدل زبانی مناسب پروژه را انتخاب کنیم؟
مدل زبانی مناسب، ارزانترین و سریعترین مدلی است که کار مشخص شما را با کیفیت قابلقبول انجام دهد؛ نه لزوماً قویترین مدل بازار. برای انتخاب، یک مجموعه آزمون کوچک از نمونههای واقعی خودتان بسازید و چند مدل را روی آن مقایسه کنید.
- کار را دقیق تعریف کنید: خلاصهسازی، دستهبندی، پاسخ به سؤال از اسناد، تولید محتوا یا کدنویسی.
- ۲۰ تا ۵۰ نمونه واقعی همراه با پاسخ مطلوب جمع کنید.
- دو یا سه مدل (یک مدل بزرگ، یک مدل کوچک و یک مدل اوپنویت) را روی همین نمونهها اجرا کنید.
- کیفیت، هزینه هر درخواست و زمان پاسخ را ثبت کنید.
- محدودیتهای غیرفنی را بسنجید: محل پردازش داده، شرایط استفاده، پشتیبانی منطقهای و ریسک قطع سرویس.
اگر داده حساس دارید یا دسترسی پایدار به سرویسهای خارجی برایتان قطعی نیست، مدلهای اوپنویت روی سرور خودتان گزینه قانونی و قابلکنترلی هستند؛ هرچند به سختافزار و نگهداری فنی نیاز دارند. برای ساخت سیستمهایی که مدل زبانی در آنها فقط پاسخ نمیدهد بلکه کار انجام میدهد، مقاله هوش مصنوعی مولد چیست نقطه شروع خوبی برای شناخت کاربردهاست.
جمعبندی
- مدل زبانی بزرگ یک شبکه عصبی ترنسفورمری است که با پیشبینی توکن بعدی، متن تولید میکند.
- توکن واحد پردازش، قیمتگذاری و محدودیت طول است و متن فارسی معمولاً توکن بیشتری مصرف میکند.
- آموزش LLM شامل پیشآموزش، تنظیم با دستورالعمل و همراستاسازی با بازخورد است.
- توهم ذاتی این مدلهاست و با منبعدهی، جستوجو و بازبینی انسانی کم میشود.
- بهترین مدل، مدلی است که روی دادههای واقعی شما با هزینه مناسب جواب بدهد.
اگر میخواهید یک مدل زبانی را به سایت، فروشگاه یا نرمافزار سازمانیتان وصل کنید، از انتخاب مدل و طراحی پرامپت تا لایه اعتبارسنجی و پیادهسازی، خدمات توسعه وب و یکپارچهسازی هوش مصنوعی siloow را ببینید. مقالات بیشتر را هم در مگ siloow دنبال کنید.
منابع
- Vaswani et al., Attention Is All You Need (arXiv, 2017)
- Google for Developers, Introduction to Large Language Models
- OpenAI, Why Language Models Hallucinate
- OWASP GenAI, LLM01:2025 Prompt Injection
سوالات متداول درباره مدل زبانی بزرگ
مدل زبانی بزرگ چیست به زبان ساده؟
مدل زبانی بزرگ یک برنامه هوش مصنوعی است که با خواندن حجم عظیمی از متن یاد گرفته ادامه محتمل یک متن را حدس بزند. ChatGPT، Claude و Gemini روی همین مدلها ساخته شدهاند و با تکرار پیشبینی توکن بعدی، پاسخ کامل مینویسند.
تفاوت LLM و ChatGPT چیست؟
LLM خود مدل است و ChatGPT محصولی است که روی مدلهای زبانی OpenAI ساخته شده. ChatGPT علاوه بر مدل، رابط گفتوگو، جستوجو، اجرای کد، حافظه و لایههای ایمنی را اضافه میکند.
توکن در مدل زبانی یعنی چه؟
توکن تکهای از متن است، مثل یک کلمه یا بخشی از کلمه، که مدل با آن کار میکند. هزینه API و محدودیت طول ورودی و خروجی بر حسب توکن حساب میشود و متن فارسی معمولاً توکن بیشتری از معادل انگلیسی مصرف میکند.
چرا مدل زبانی جواب غلط میدهد؟
مدل برای تولید متن محتمل آموزش دیده، نه برای بیان فقط حقایق تأییدشده، و معیارهای ارزیابی رایج هم حدس زدن را تشویق میکنند. کمبود داده درباره موضوع، تاریخ قطع دانش و پرامپت مبهم احتمال این توهم را بیشتر میکند.
آیا میتوان مدل زبانی را روی کامپیوتر شخصی اجرا کرد؟
بله، مدلهای اوپنویت کوچکتر مثل نسخههای کوچک Gemma یا Qwen را میتوان روی کامپیوتر یا سرور شخصی اجرا کرد. کیفیت آنها معمولاً از بزرگترین مدلهای بسته کمتر است اما کنترل کامل داده را به شما میدهند.
پنجره زمینه بزرگتر همیشه بهتر است؟
نه لزوماً. پنجره بزرگ اجازه میدهد اسناد طولانیتری بدهید، اما هزینه و زمان پاسخ را بالا میبرد و مدل همه بخشهای متن طولانی را با دقت یکسان به کار نمیگیرد. برای پایگاه دانش بزرگ، بازیابی هدفمند اطلاعات معمولاً بهتر جواب میدهد.
منبع: arxiv.org